Sobre el papel
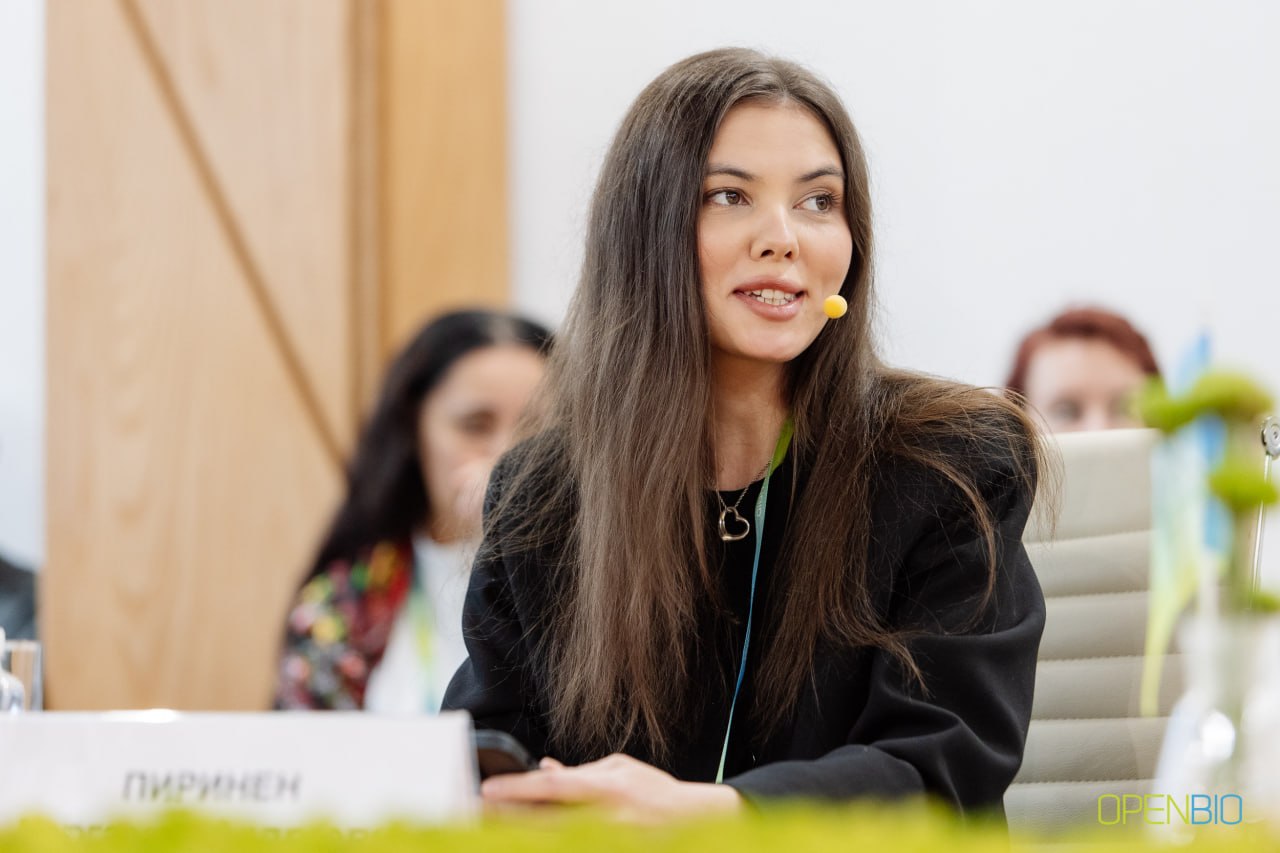
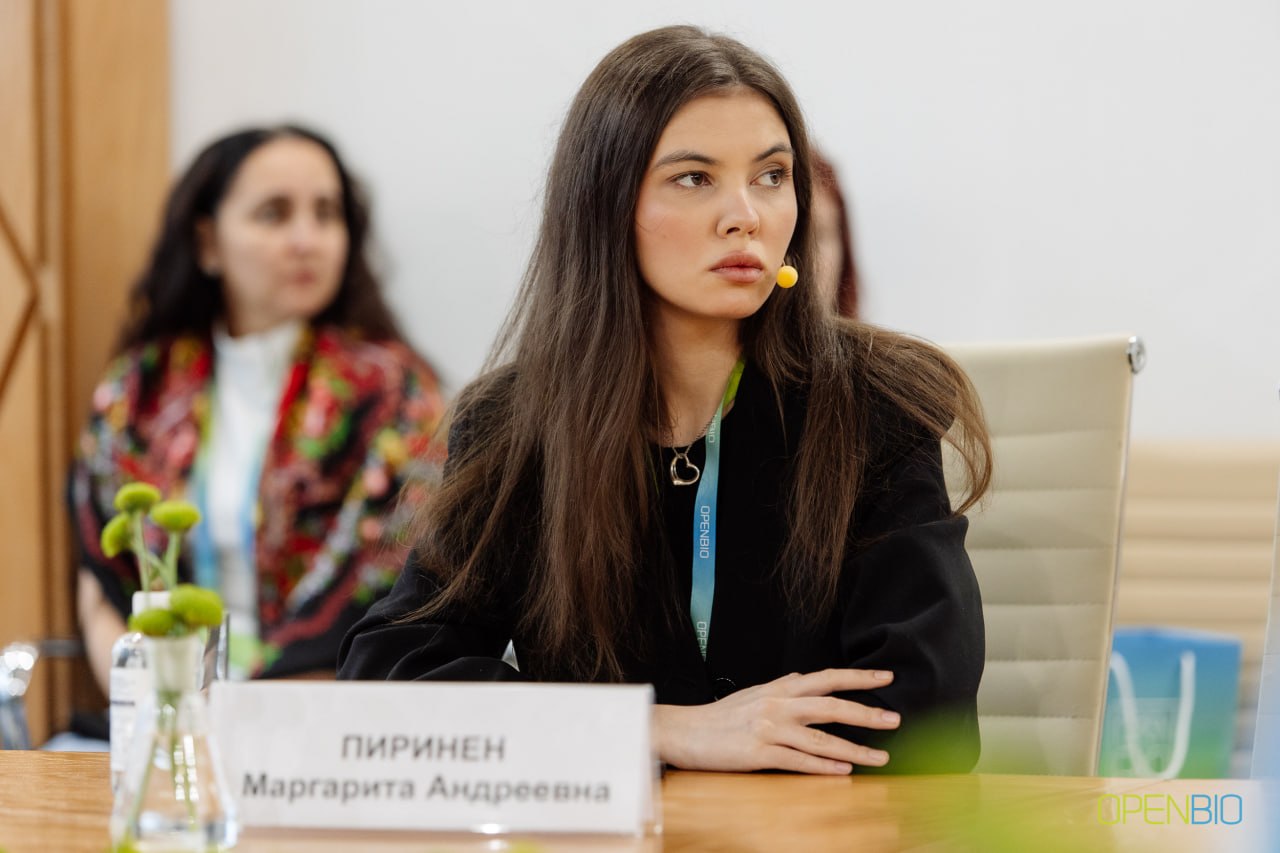
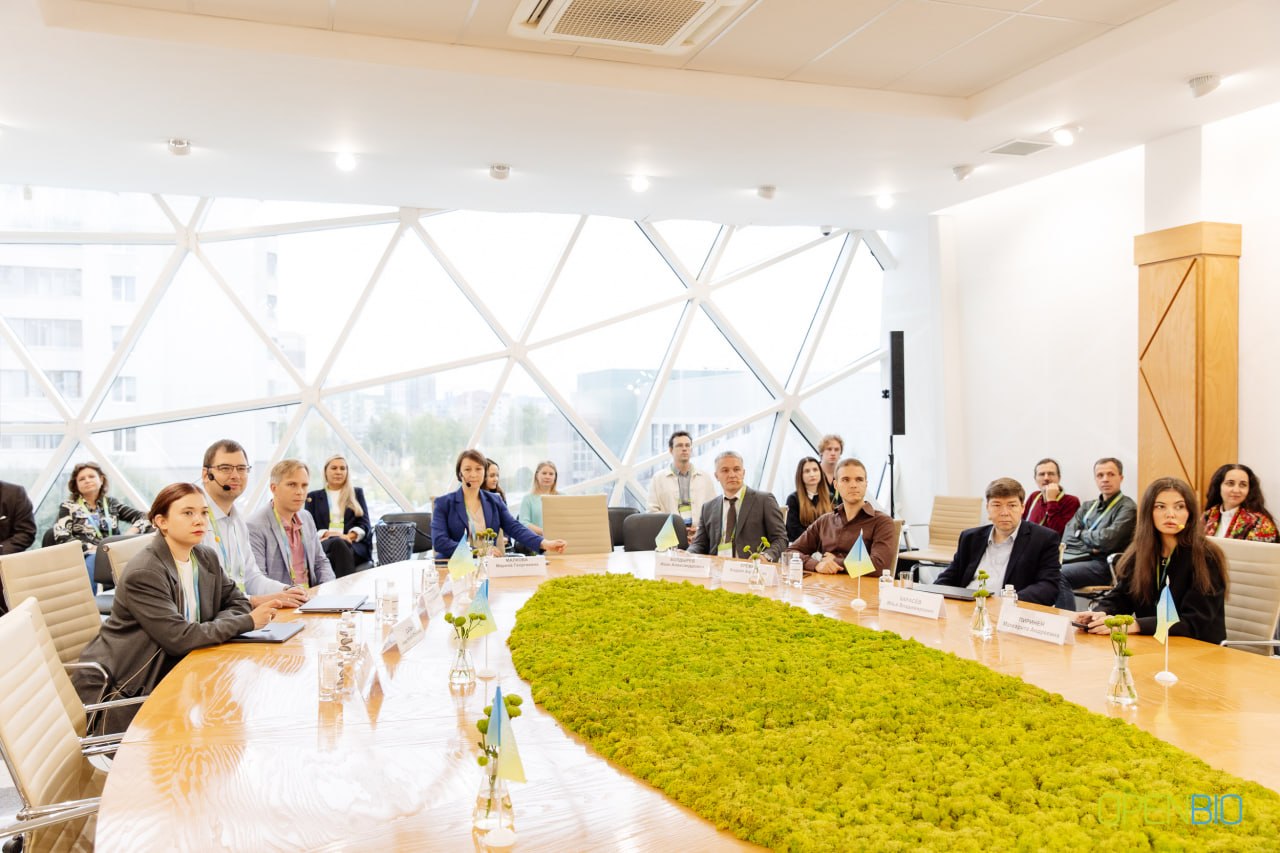
El texto siguiente presenta el documento de conferencia presentado por Margarita Pirinen, fundadora y CEO de BIOS, en el 13o Foro de Biotecnología Ruso OpenBio 2026 en la ciudad científica de Koltsovo.
La presentación formó parte de la sesión de expertos “Tecnologías y productos de la biotecnología rusa e internacional: lo que está disponible para el mercado ruso ahora mismo”. Su título fue “La próxima generación de IA médica: un modelo dinámico de salud”.
Propósito del papel — para establecer una dirección para la próxima generación de IA médica: desde documentos individuales y mediciones a un modelo dinámico de la salud de una persona. Utilizando BIOS como ejemplo, muestra cómo comenzar a construir las bases tecnológicas para la medicina que preserva una historia personal continua, rastrea los cambios y, en el tiempo, modelos de trayectorias de salud.
Principales objetivos: considerar la condición de una persona a lo largo del tiempo como un objeto de computación; conectar una hipótesis de investigación fundamental con productos de trabajo y economía empresarial; establecer principios arquitectónicos que permitan evolucionar las tecnologías sin perder datos y conocimientos acumulados; y especificar lo que debe demostrarse antes de modelar los estados y sus cambios. La pregunta general es cómo la biotecnología rusa puede establecer sus propias direcciones tecnológicas y desarrollar soluciones para problemas que el mercado aún no ha articulado.
Tres puntos clave
- 01
El liderazgo tecnológico requiere no sólo nuevos productos, sino continuidad de datos, estándares e interfaces.
- 02
BIOS trata la condición de una persona con el tiempo como objeto arquitectónico; el modelo de transición requiere una validación experimental separada.
- 03
El valor de la infraestructura debe medirse mediante la calidad del contexto, el tiempo de trabajo, la portabilidad y el costo total de la propiedad.
La soberanía tecnológica comienza con la infraestructura
Este documento trata las lagunas tecnológicas, especialmente en la biotecnología, como un problema sistémico que no puede reducirse a la ausencia de un solo instrumento, reactivo, paquete de software o inversor.
Al examinar la infraestructura tecnológica de la biotecnología rusa, nos enfrentamos a preguntas concretas: qué soluciones ya están disponibles para los laboratorios; cómo asegurar resultados comparables y reproducibles; cómo conectar el equipo de diferentes fabricantes, software y datos; y cómo llevar a cabo una investigación sólida en la práctica cotidiana.
Una pregunta más pertenece a este programa: ¿Cómo resolver los problemas de hoy también construir la infraestructura tecnológica de mañana?
Este documento define la soberanía tecnológica como la capacidad de identificar independientemente la próxima clase de tecnologías requerida, crearla, demostrar que funciona e integrarla en la economía real. Las alternativas internas son necesarias, pero no agotan esa tarea.
Este argumento se desarrolla a través de BIOS. La autora, Margarita Pirinen, es la fundadora y CEO de la empresa que desarrolla BIOS y el autor de la tecnología, que en OpenBio se convirtió en un galardonado en la competencia de Elección de la Comunidad Científica. Este reconocimiento nos importa especialmente: BIOS comenzó como una hipótesis de investigación, pero nunca la construimos como investigación por su propio bien.
BIOS es un negocio. Durante los últimos años, hemos estado abordando una pregunta práctica: ¿podemos desarrollar una tecnología suficientemente fundamental para el próximo ciclo de desarrollo de la medicina, al tiempo que la convertimos en productos utilizados por médicos, clínicas y pacientes? Combinar estos objetivos requiere un enfoque diferente de la innovación y la infraestructura.
1. Hoy no hay escasez de tecnología
El trabajo en BIOS ha implicado encontrar docenas de proyectos relacionados en aceleradores, concursos y programas tecnológicos, así como orientar varias soluciones en campos adyacentes. Esta experiencia ha permitido comparar diferentes enfoques para desarrollar tecnologías médicas y llevarlos al mercado.
Nuestra experiencia con BIOS sugiere que el problema no es tanto una escasez de productos como su desconexión. Las soluciones van desde unos cientos de rublos hasta varios miles y plataformas empresariales: interpretación de datos de laboratorio, auxiliares médicos, integraciones de dispositivos, agregadores de documentos y sistemas de apoyo a las decisiones.
Queda una paradoja: la demanda existe, los desarrollos y las conclusiones científicas son abundantes, pero el camino al uso sostenido sigue siendo difícil. El problema debe ser más profundo que la ausencia de una solución.
Una posible razón es la separación de la investigación y el pensamiento emprendedor. Un investigador debe crear algo fundamentalmente nuevo; un empresario debe descubrir lo que el mercado quiere comprar hoy. Cada lógica es independientemente, pero separarlos se convierte en un obstáculo en la tecnología biomédica.
El mercado puede describir muy bien su problema actual. No está obligado a articular la arquitectura de una tecnología que resolverá ese problema en cinco o diez años.
Si un médico dice, ‘Me lleva demasiado tiempo entender la historia de un paciente’, una excelente herramienta de búsqueda de documentos podría abordar esa necesidad inmediata. Pero la pregunta se puede tomar un nivel más profundo: ¿Por qué los médicos deben reconstruir manualmente la condición de un paciente de documentos separados cada vez?
Comenzamos a diseñar un sistema diferente: no una herramienta para encontrar información más rápido, sino una infraestructura que preserve el contexto continuo sobre la condición de una persona. Esta distinción entre tratar un síntoma local y abordar su causa se convirtió en uno de nuestros principios de diseño central para BIOS.
Tres generaciones de HealthTech en la evolución de la inteligencia artificial
Este artículo distingue tres generaciones de HealthTech según la tarea tecnológica que un sistema dirige: digitalizar la práctica médica, extraer el significado de datos o modelar la condición de una persona con el tiempo. La secuencia ayuda a explicar la arquitectura BIOS y su lugar en la IA médica. Estas generaciones coexisten: nuevos modelos operan en la parte superior de la infraestructura digital, y una plataforma puede combinar capacidades desde varias etapas.
HealthTech 1.0: medicina digitalizada
La primera tarea importante era convertir la información médica y los flujos de trabajo en forma digital. Los gráficos de papel se convierten en registros electrónicos, las formas individuales se convierten en resultados en sistemas de laboratorio, y el cine se convierte en un archivo de imagen digital. Las citas, recetas, facturación, intercambio de documentos y acceso de los pacientes a sus historias se convierten en funciones de software.
Esta generación se basa en bases de datos, sistemas de almacenamiento, identificación de pacientes, interfaces de intercambio y gestión del acceso. Los sistemas de información médica, los sistemas de información de laboratorio y los archivos de imágenes abordan diferentes partes del problema. Conectarlos requiere formatos alineados, terminología e identificadores: ¿un registro pertenece a la misma persona, qué se midió, en qué unidades y cuándo? La calidad de integración ya determina si los datos pueden posteriormente apoyar la computación.
Los productos en esta categoría son familiares. En Moscú, el registro electrónico en EMIAS proporciona acceso a notas de examen, resultados de laboratorio y resúmenes de descarga. El sistema ruso de información médica MEDODS combina citas, registros médicos, notas de consulta, resultados de pruebas y flujos de trabajo de laboratorio. El portal del paciente MyChart proporciona acceso a resultados, medicamentos, citas e intercambio de información médica. Esta comparación se refiere a las funciones de digitalización, no a las capacidades completas de estas plataformas en evolución.
Los tejidos extienden esta capa añadiendo mediciones diarias a datos clínicos. Producen series temporales de actividad, frecuencia cardíaca y otras señales. Recopilarlos y mostrarlos no significa que un sistema pueda explicar cambios en la salud, sino suministrar material para la próxima etapa.
La unidad básica de esta generación es un registro digital de un evento. El sistema sabe que se produjo una cita, se llegó un resultado de prueba o se emitió una receta. Puede almacenarlos juntos, pero los médicos a menudo reconstruyen las propias relaciones clínicas. Un registro electrónico completo y un modelo coherente de la condición de una persona son diferentes resultados tecnológicos.
La digitización solucionó el problema de la disponibilidad al mismo tiempo que aumentaba el volumen de la información a procesar. La historia de una persona acumula documentos de diferentes especialidades, resultados de diferentes laboratorios, exámenes repetidos y datos de dispositivos. Cuanto más tiempo sea la historia, más esfuerzo se necesita para identificar lo que importa y conectar eventos. La siguiente tarea sigue: los datos están disponibles; ahora debe ser procesado e interpretado.
HealthTech 2.0: IA generativa y análisis automatizado
La siguiente tarea es automatizar el trabajo con el contenido de la información médica. Dos direcciones conectadas emergen: algoritmos especializados para tareas específicas, y modelos adaptables a muchas tareas. La medicina gana herramientas para reconocer imágenes y señales, evaluar riesgos, extraer hechos, preparar documentos y conversar con los usuarios.
La evolución de la IA explica por qué estas herramientas difieren. Sistemas de expertos ejecutan reglas definidas por humanos. El aprendizaje clásico de la máquina identifica relaciones en las características preparadas. Las redes neuronales profundas aprenden características directamente de imágenes, textos y señales. Un modelo puede detectar signos de enfermedad en una imagen, otro analizar un ECG, y un tercero calcular el riesgo de un conjunto de mediciones. El desarrollo de estas aplicaciones se describe en Revisión de la IA médica de Eric Topol.
En una tarea especializada, los desarrolladores definen de antemano los insumos, la variable objetivo y el criterio de calidad. Una nueva tarea a menudo requiere diferentes etiquetas, sintonización y validación. La alta precisión en reconocer una característica no significa que el algoritmo pueda interpretar toda una historia del paciente.
El próximo gran cambio en la IA implica modelos de fundación. Preentrenamiento a gran escala construye representaciones que pueden adaptarse a diferentes tareas. En el aprendizaje autosupervisado, la señal de entrenamiento viene de los datos mismos: por ejemplo, un modelo reconstruye partes ocultas de texto o imagen. Esto reduce la dependencia de la etapa de preentrenamiento del etiquetado manual para cada tarea clínica.
La arquitectura Transformer y su mecanismo de atención, que captura las relaciones entre elementos de secuencia, desempeñaron un papel importante. Un modelo de fundación no necesita ser lingüístico o generativo, sin embargo: las representaciones reutilizables se pueden aprender de imágenes, señales fisiológicas y combinaciones de modalidades. En la medicina, esto permite trabajar conjuntamente con texto, imágenes y mediciones, así como transferir a tareas con etiquetas limitadas, una dirección establecida en Papel de Moor y colegas sobre AI médico generalista.
Un ejemplo concreto es RETFound: preentrenamiento autosupervisado sobre imágenes retinales proporciona una base para la adaptación a tareas de detección de enfermedades. Esto cambia la economía de la formación: parte de la representación se aprende de antemano y se reutiliza, aunque cada aplicación médica todavía requiere su propia evaluación de calidad.
A nivel de producto, esto se puede ver en Microsoft Dragon Copilot: AI ayuda a preparar la documentación clínica, que el médico revisa y completa. Esta es una automatización específica del procesamiento del lenguaje y el contenido médico incrustado en un flujo de trabajo.
Los sistemas también ganan la recuperación de fuentes externas - generación aumentada de recuperación, o RAG- e integración de herramientas. Un modelo puede recuperar documentos relevantes, llamar módulos computacionales y responder usando el contexto recuperado. Esto amplía las capacidades de la interfaz pero crea desafíos de ingeniería separados: integridad de recuperación, moneda de origen, extracción de hechos correctos y verificación de acciones realizadas.
Otro ejemplo de nuestro mapa de la competencia es Paciente GPT por K Health: las conversaciones con los pacientes están vinculadas a sus registros médicos y la organización de cuidados posteriores. La integración del modelo en la vía clínica importa tanto como su respuesta. Por lo tanto, la segunda generación no puede reducirse a chatbots aislados: los productos están incorporando progresivamente contexto, herramientas e interacción con los médicos.
El principal avance de esta etapa es la capacidad de los algoritmos para interpretar los datos médicos; los modelos de fundación también pueden reutilizar las representaciones aprendidas. Estas representaciones pueden soportar muchas tareas y secuencias largas. Por lo tanto, el límite de la próxima generación no puede definirse simplemente por tiempo, memoria o una gran ventana contextual: los modelos contemporáneos pueden tener ya los tres. Para nosotros, el siguiente paso se refiere a cómo se organiza todo el sistema y a qué se pretende modelar.
¿Por qué la AI generativa no es suficiente?
Conectar un modelo de lenguaje a un registro electrónico parece natural: lee documentos, extrae hechos, prepara resúmenes y responde preguntas. Pero aprender a predecir las continuaciones de texto no establece la verdad de cada reclamo médico o las reglas para mantener un historial paciente. Estas propiedades deben ser aseguradas por el sistema en su conjunto.
El primer problema es alucinaciones y omisiones. Un modelo puede agregar un hecho ausente, tergiversar una negación o omitir un detalle importante al resumir una historia. En un papel Asgari y colegas en npj Medicina Digital estos errores se evalúan por separado con respecto al riesgo clínico. Los autores muestran que la calidad depende de la configuración del flujo de trabajo: un paso adicional de procesamiento no necesariamente mejora el resultado. Las aplicaciones médicas deben evaluar tanto lo que dice un sistema como lo que deja fuera.
El segundo problema es la memoria. Una ventana contextual contiene información para el cálculo actual, pero no determina en sí mismo qué retener entre las visitas, cómo contabilizar las correcciones o cuándo revisar una conclusión anterior. La suma repetida no es sustituto de la memoria médica: la compresión sucesiva puede perder una fuente, fecha, calificación o relación a una prescripción. "Recuerdo inteligente" aquí significa una historia manejada de hechos y cambios, no sólo una conversación guardada.
El tercer problema es la organización computacional. Si cada respuesta requiere reprocesar un gran archivo, los costos de lectura y recuperación crecen con la historia. Sin embargo, calcular las tendencias, comprobar las unidades y interpretar el texto son diferentes tipos de trabajo. Un modelo de lenguaje no necesita realizar cada operación. El sistema debe determinar qué datos ya se han procesado, qué cálculos son reproducibles y qué nuevos eventos requieren realmente una reevaluación.
Los sistemas modernos abordan estas limitaciones mediante mecanismos de recuperación, memoria externa, herramientas y verificación. Por lo tanto, el progreso implica más que sustituir un modelo por otro. La siguiente pregunta es qué objeto debe organizar este trabajo para que cada nueva interacción continúe la historia médica en lugar de reafirmar su interpretación.
HealthTech 3.0: modelar la salud con el tiempo
En esta clasificación, la tercera generación se define por su tarea, no por el nombre de un algoritmo. Un sistema debe mantener un modelo actualizado de la condición de una persona, incorporando historia acumulada, nuevas observaciones, sus condiciones de adquisición e incertidumbre. La siguiente tarea de investigación consiste en describir patrones de cambio y contrastar las predicciones con observaciones posteriores.
Entendemos el estado de salud como una representación computable de una persona en un momento particular, construida a partir de datos disponibles. Incluye mediciones observadas, sus relaciones y trayectorias, acontecimientos e intervenciones importantes y lagunas de información. No es un único índice de salud o una lista de diagnósticos. Dos personas con la misma medición actual pueden tener diferentes bases de referencia, direcciones de cambio y condiciones de medición, y por lo tanto diferentes contextos para la evaluación.
Científicamente, este es un problema de reconstruir un sistema dinámico parcialmente observado. No midemos todo el organismo: diferentes pruebas proporcionan observaciones incompletas en diferentes momentos. La dinámica fisiológica debe distinguirse de la forma en que se observan. Más pruebas, por ejemplo, pueden reflejar un seguimiento más intensivo en lugar de empeorar la salud. El modelo debe considerar el tiempo, la falta y la procedencia de los datos, no sólo los valores en una tabla.
Esta formulación está bien ilustrada PULSE, un documento de Wu y colegas de Nature Computational Science. Los autores combinan un estado anterior personalizado, Estado pasado, con mediciones de corriente incompleta para formar el Estado visitante. En las tareas estudiadas, la historia ayuda a reconstruir las modalidades desaparecidas y a crear características predictivas. Aquí, el estado es una representación latente aprendida, demostrando que una tarea de tercera generación no requiere una arquitectura única, necesariamente neuro-simbólico.
Reconstruir un estado de datos incompletos
En nuestra arquitectura, los datos incompletos se convierten en parte del modelo. Reconstruimos los componentes estatales para los cuales hay pruebas, conservamos la incertidumbre e identificamos la información necesaria para el perfeccionamiento. El médico recibe no sólo un conjunto incompleto de documentos, sino un relato de lo que se conoce y donde se encuentran las lagunas específicas.
Hay que distinguir dos operaciones. La primera conecta los hechos existentes y reconstruye la parte accesible de un estado. La segunda calcula una cantidad sin reservas utilizando un modelo entrenado. Tal estimación se mantiene con su método e incertidumbre y no reemplaza una prueba real. La reconstrucción significa ampliar una representación respaldada por pruebas de una persona, sin llenar cada campo vacío con números plausibles.
Evaluar un cambio puede requerir una base de referencia perdida, una medición de repetición comparable, la fecha de un cambio de tratamiento o información sobre las condiciones de prueba. Los datos pueden ser obsoletos o contradictorios. Identificamos la brecha relativa a una tarea particular: lo que no se puede reconstruir con confianza y qué información podría aclararla.
El siguiente paso es comparar posibles observaciones por cuánto pueden reducir la incertidumbre. Esto requiere un modelo de resultados probables y su efecto en la estimación estatal. El valor de la información debe pesarse contra la idoneidad clínica, el riesgo, la disponibilidad y el costo. El sistema ayuda así a formular la siguiente pregunta, mientras que la decisión de ordenar un examen permanece con el médico.
Lo que un modelo estatal cambia en la práctica
Considere un escenario hipotético: una persona tiene varios años de resultados de laboratorio, luego llegan cambios de tratamiento y nuevas mediciones. Un archivo digital muestra los documentos. Un asistente de inteligencia artificial puede preparar un resumen. Un modelo estatal también debe conectar las mediciones a la trayectoria e intervención anterior, comprobar la comparabilidad, identificar cambios y mostrar qué conclusiones ahora necesitan revisión.
Esto permite preguntas más sustantivas. ¿Está cambiando una medición relativa a la base de referencia del individuo? ¿Su trayectoria es consistente con otras observaciones? ¿Qué información falta para distinguir un cambio persistente de la variabilidad de medición? ¿Qué partes de la descripción anterior ya no son actuales? Los médicos necesitan estas respuestas para elegir el siguiente paso de monitoreo; los investigadores necesitan que formulen hipótesis probables.
Un nivel más complejo implica la predicción: ¿cómo puede el Estado cambiar en condiciones e intervenciones específicas? Deben distinguirse las trayectorias esperadas, los cambios observados y los efectos causales. La secuencia “prescripción — cambio de medición” no establece un efecto de tratamiento. Esas conclusiones requieren datos apropiados y diseño de estudios.
La importancia de esta transición es que la medicina puede abordar cambios en la salud, en lugar de sólo el resultado de un examen. Esto proporciona una base para la vigilancia personalizada, la detección previa de cambios significativos y las respuestas de pruebas a las intervenciones. El nuevo modelo no reemplaza el diagnóstico; debe conectar los eventos diagnósticos individuales en un proceso que puede ser estudiado sistemáticamente.
Dentro de la evolución más amplia de la IA, varias direcciones se encuentran aquí: series temporales y modelos de estado latente, representaciones multimodales, métodos gráficos, modelos mecánicos, sistemas neuro-simbólicos y aprendizaje de operadores. Una combinación más amplia de modelos a escalas biológicas se examina internacionalmente en la Programa de organismos digitales impulsados por inteligencia artificial. La elección de la tecnología depende de lo que reconstruimos, lo que predicemos y cuáles limitaciones podemos probar.
Nuestro enfoque: la arquitectura híbrida BIOS
Esta es la arquitectura hacia la que BIOS se mueve estratégicamente. Su tarea es conectar la memoria médica, la reconstrucción estatal y el estudio de la dinámica en un solo sistema que se desarrolla a medida que se acumulan datos y conocimientos.
En BIOS hemos elegido una combinación de métodos. Los componentes neuronales procesan datos heterogéneos; la memoria médica conserva historia; reglas simbólicas y un gráfico de conocimiento proporcionan relaciones explícitas y cheques. Los modelos dinámicos abordan una tarea diferente: describir los cambios estatales. Una arquitectura híbrida permite a cada operación utilizar un método computacional apropiado, en lugar de pedir un modelo de lenguaje para almacenar la historia, conocer la medicina, calcular y predecir simultáneamente.
El enfoque neuro-simbólico es una parte de esta solución. Combina el aprendizaje de datos con procedimientos de conocimiento y razonamiento explícitamente representados; esta combinación es objeto de Aprendizaje y Reasonamiento NeurosymbolicoPara nosotros, su valor es la capacidad de separar una interpretación probabilísticamente propuesta de la evidencia formalmente verificable.
Cómo se distribuyen las funciones dentro de BIOS
Nuestra arquitectura separa funciones que pueden fácilmente conflarse en una conversación modelo ordinaria. Leer un documento, almacenar un hecho, calcular un cambio, proponer una hipótesis y explicarlo a un médico son cinco operaciones diferentes. Cada uno necesita sus propios insumos, reglas y controles de salida.
- La capa neural extrae información. Texto, imágenes o señales se convierten en características y datos médicos candidatos. Un formulario de laboratorio, por ejemplo, requiere la extracción del nombre de medición, valor, unidades y fecha. Los errores de reconocimiento son posibles en esta etapa, por lo que el valor extraído debe permanecer vinculado al documento original.
- La memoria médica proporciona contexto. Una observación tiene su lugar en la historia junto con su fuente, tiempo y condiciones de medición disponibles. La corrección de un médico no debe borrar el registro anterior sin un rastro. Los datos perdidos se registran como desconocidos: si no se menciona un síntoma, no se puede asumir su ausencia.
- La capa simbólica establece significado y limitaciones. Una ontología describe los tipos de concepto médico y las relaciones permisibles, un gráfico conecta información específica, y las reglas definen las condiciones para la comparación e inferencia. Los cheques incluyen compatibilidad de unidad, orden de evento y la presencia de entradas requeridas. “Mesurado después de una receta” no debe ser automáticamente “cambiado debido a la prescripción”.
- La capa computacional produce una versión estatal. Tratamos el estado como un objeto distinto: qué observaciones se utilizaron, qué cambios se detectaron, qué permanece desconocido, y qué versiones de regla y modelo produjeron el resultado. Cuando llegue una nueva prueba, el sistema debe identificar qué partes de la representación necesitan actualizar y preservar los motivos de revisión.
- La interfaz de idioma explica el resultado. Un LLM ayuda a formular respuestas e interactuar con herramientas computacionales. Las respuestas se basan en hechos almacenados y resultados de comprobación. Una hipótesis clínica debe presentarse como hipótesis; una reclamación no apoyada no debe ser representada como un hecho establecido.
Esta es la distinción entre la recuperación de documentos y un sistema neuro-simbólico. RAG selecciona texto para un modelo a utilizar en la respuesta. Nuestra arquitectura también debe almacenar hechos escritos y sus dependencias, aplicar cheques formales y rastrear qué conclusiones cambian cuando se actualizan los datos. El gráfico puede ayudar a la recuperación, pero su valor principal para nosotros reside en representar explícitamente el contexto médico y la base para la computación.
El determinismo se aplica a operaciones específicas: entradas idénticas y versiones de reglas deben producir resultados de verificación idénticos. Un modelo probabilístico estima la incertidumbre, una capa formal revisa las limitaciones definidas y un médico evalúa el significado clínico. Esta separación permite que los errores de cada componente sean estudiados en lugar de juzgar el sistema únicamente por lo convincente que suena su texto final.
Un gráfico de conocimiento acumulativo y verificación de resultados
La memoria de un individuo debe estar separada de la base general de conocimiento médico. Memoria almacena observaciones, documentos y eventos de la historia de esa persona. El gráfico de conocimiento almacena conceptos médicos, relaciones y reglas con condiciones de aplicabilidad. Una relación gráfica no se convierte en un hecho sobre un paciente: aplicarlo requiere datos apropiados de su historia.
En BIOS, el proceso de investigación está separado de las conversaciones con los pacientes. Sigue publicaciones científicas, directrices y otras fuentes, comprueba la procedencia y versiones de documentos y extrae reclamaciones junto con sus condiciones y limitaciones. La evidencia se almacena en un registro y relaciones en un gráfico de investigación. La nueva información puede apoyar una hipótesis, debilitarla, reducir su aplicabilidad o dejarla con un estado de “datos insuficientes”. Se mantienen versiones anteriores.
Una directriz, una clasificación oficial y un estudio individual proporcionan diferentes tipos de pruebas. Las copias de una publicación no cuentan como corroboración independiente, y los datos contradictorios no se eliminan para producir una sola respuesta. Trasladar conocimiento del grafo de investigación a una regla aplicada es un procedimiento aparte que tiene en cuenta el tipo de afirmación, la fuente, la versión y las condiciones.
Por lo tanto, la acumulación de conocimiento no requiere que el modelo de conversación declare sus propias respuestas verdaderas. Su propuesta puede ser examinada a través del proceso de investigación, pero no debe convertirse automáticamente en una regla para verificar las respuestas posteriores. Necesitamos evitar la confirmación circular en la que un sistema inventa una relación y luego la cita como evidencia.
El mecanismo de verificación determinista aplica reglas fijas a los datos. Puede detectar unidades incompatibles, una condición requerida desaparecida o una contradicción entre una reclamación y su fuente. Con entradas idénticas y versiones de reglas, el cheque es reproducible. Esto hace que el gráfico sea un instrumento de control, mientras que la integridad de su conocimiento y la corrección clínica de sus reglas siguen siendo preguntas de investigación separadas.
Un enfoque relacionado pero diferente es ilustrado por InfEHR, publicado en Nature Communications: una historia médica se convierte en un gráfico temporal, en el que se aprenden representaciones para la inferencia probabilística con pocos ejemplos etiquetados. Este no es el mismo mecanismo que el control de reglas deterministas. El ejemplo importa porque cómo se organiza una historia afecta a los requisitos de capacitación y las posibilidades analíticas posteriores.
Por qué todo el sistema no necesita ser reeducado
No hacemos una reeducación larga del modelo de lenguaje un requisito para cada actualización al conocimiento médico. Se utiliza un modelo preentrenado donde se necesitan sus capacidades lingüísticas y perceptivas. Una relación recién confirmada puede entrar en la base de conocimiento externo, una regla puede entrar en el mecanismo de verificación, y una nueva observación puede entrar en la memoria del paciente. Estos cambios no requieren necesariamente cambiar pesos de red neuronal.
Estos son tres procesos separados: los parámetros de cambios de formación modelo; la investigación expande y perfecciona el conocimiento; la actualización estatal aplica métodos disponibles a un nuevo historial de observación. Separarlos permite que las capacidades crezcan sin repetir un ciclo completo de entrenamiento después de cada cambio. La verificación de datos y conocimientos todavía requiere trabajo, pero ese trabajo se hace objetivo y rastreable.
Nos relacionamos con la exactitud de la calidad de toda esta secuencia: fue el hecho extraído correctamente, fue la regla aplicada correctamente, y ¿hay pruebas suficientes para la conclusión? La verificación basada en el Gráfico debe limitar ciertas clases de error. La demostración de las ganancias en calidad y eficiencia requiere medidas definidas por separado: exactitud de extracción, omisiones críticas, reclamaciones no apoyadas, tiempo de procesamiento y costo de actualización. Esto nos permitirá evaluar el gráfico, la memoria y los modelos por resultados en lugar de lenguaje persuasivo.
Operadores neuronales: una tarea separada de la dinámica de modelado
Los operadores neuronales complementan esta arquitectura de otra dirección. Un gráfico de conocimiento ayuda a verificar evidencia y limitaciones; un modelo de operador aprende las transformaciones entre funciones, como las condiciones de asignación especificadas a la trayectoria de un sistema modelado. En el Papel de Operador Neural Fourier este enfoque fue estudiado en familias de ecuaciones diferenciales, incluyendo problemas de dinámica de fluidos.
Para BIOS, esta es una dirección de investigación para las transiciones estatales. En lugar de una respuesta aislada sobre las mediciones de hoy, nos interesa reproducir patrones de cambio en condiciones específicas. Un operador también requiere entrenamiento. Su valor potencial es reutilizar relaciones aprendidas dentro de su dominio de aplicabilidad, no en la dispensación de datos de capacitación. Esta hipótesis se examina detalladamente en la sección de operadores neuronales.
El híbrido conecta así diferentes tipos de trabajo: una red neuronal extrae una representación, la memoria preserva la historia, un gráfico limita las interpretaciones admisibles, un modelo computacional describe el estado, y un enfoque del operador investiga su dinámica. Podemos cambiar y probar estos componentes por separado preservando su objeto común: una persona y su historia.
El propósito práctico de esta distinción es entender lo que estamos construyendo y cómo se evaluarán sus resultados. Un archivo digital necesita integridad y disponibilidad. Un modelo individual necesita realizar bien su tarea. Un sistema que acompaña a una persona a lo largo del tiempo también necesita un contexto estable, una revisión correcta de las conclusiones y una evaluación contra futuros acontecimientos.
Donde BIOS encaja
La transición de la primera a la segunda generación es visible en cómo se enmarcan hoy las tareas del producto: una historia digital debe leerse, condensarse, buscarse y usarse para preparar una respuesta. Desde el principio, el BIOS recibió una tarea de tercera generación —el estado de modelado con el tiempo— y elegimos una arquitectura híbrida para abordarla. En BIOS, el objeto del trabajo es una persona con una historia en evolución, alrededor de la cual se construyen modelos y productos individuales.
Un escenario hipotético hace la distinción más clara. Una persona trae varios años de resultados de prueba. Un sistema de primera generación los almacena y proporciona búsqueda y acceso. Un sistema de segunda generación utiliza representaciones preentrenadas para extraer mediciones, resumir la historia y apoyar diferentes tareas. En la tercera generación, la tarea continúa: un nuevo resultado debe actualizar la historia general, preservar las relaciones con las recetas y las mediciones anteriores, y mostrar cambios y motivos significativos para nuevas comprobaciones. Esta es la secuencia que estamos construyendo en BIOS. El modelado de transición estatal es la siguiente capa de investigación de la arquitectura.
Lo que crea una ventaja tecnológica
Para BIOS Personal, Doctor y Clínica, esto significa utilizar una memoria médica compartida a través de diferentes interfaces. Los pacientes necesitan entender los cambios y prepararse para las consultas; los médicos necesitan reconstruir los eventos y verificar las pruebas; las clínicas necesitan continuidad de la vigilancia. El uso de la investigación añade requisitos de protocolo, consentimiento y control de acceso. Queremos evitar reconstruir una representación separada de una persona para cada producto.
La primera ventaja es la independencia del conocimiento acumulado de una determinada red neuronal. Si los hechos, las relaciones y las versiones estatales se almacenan por separado, se puede actualizar un modelo de extracción o una interfaz de idioma sin recrear toda la historia médica. Esto reduce la dependencia arquitectónica del ciclo de vida de un solo modelo.
El segundo es la capacidad de actualizar los cálculos en respuesta a los cambios. Un nuevo documento no siempre requiere reanualizar toda la historia. Las dependencias de gastos identifican los cálculos y conclusiones afectados. Cuando una nueva observación cambia la interpretación de datos antiguos, la recalculación debe incluirla. Las ganancias prácticas se miden en el tiempo de procesamiento y el costo de actualización preservando la calidad.
El tercero está reutilizando conocimientos y componentes a través de tareas. Normalizar una medición, situarlo en el tiempo y comprobar la comparabilidad son necesarios para los servicios de pacientes, médicos y protocolos de investigación por igual. Esperamos reducir el trabajo de ingeniería repetido. Una menor necesidad de datos de capacitación especializados es una hipótesis separada que debe ser probada comparando modelos.
El cuarto es la reproducibilidad de la investigación. Fuentes, versiones y límites retenidos de lo que se conoce nos permiten reconstruir la base de un resultado en un momento determinado. Los métodos pueden compararse en la misma historia, las contribuciones a los componentes probadas e información que aparecieron sólo después de excluir el evento evaluado. Para la ciencia, esto importa tanto como la precisión predictiva.
La ventaja prevista a largo plazo radica en acumular los resultados de esta labor. Cambiar un modelo de idioma no debe restablecer la memoria médica. Conectar un laboratorio debe extender las observaciones disponibles. Probando una hipótesis debe dejar un método reproducible para la siguiente tarea. Cada nuevo producto hereda una fundación que de otro modo tendría que ser reconstruida.
Esta fundación podría proporcionar una ventaja durante años: su valor proviene de datos alineados, relaciones verificadas, protocolos de evaluación y experiencia de implementación. Nuestra prueba de ello es concreta: demostrar que, a medida que se desarrolla el sistema, la siguiente fuente es más fácil de conectar, una nueva tarea requiere un desarrollo menos repetido y la calidad sobrevive la transferencia. Estos resultados expresarán nuestra ventaja.
Para la ciencia, esto permite el estudio de secuencias de cambios, un retorno a las observaciones originales y la comparación de hipótesis sobre la misma historia. Para la práctica médica, preserva la continuidad entre especialistas y etapas de monitoreo. Para los individuos, evita tener que contar su historia de salud desde el principio en cada consulta.
2. La unidad de análisis ya está cambiando en todo el mundo
Esta no es sólo nuestra hipótesis. La investigación internacional muestra un movimiento sostenido desde mediciones individuales hacia representaciones longitudinales de personas.
En julio de 2026, Google Research SensorFM introducido, un modelo entrenado en más de un trillón de minutos de datos utilizables de cinco millones de personas. Funciona con largas secuencias fisiológicas en lugar de mediciones aisladas de frecuencia cardíaca o actividad y transfiere la representación aprendida a decenas de tareas relacionadas con la salud.
En septiembre de 2026, Nature Medicine publicó un estudio reconstruyendo trayectorias computables del paciente longitudinal de datos estructurados y notas clínicas ordinarias. Los investigadores reconstruyeron cambios de medición después del inicio del tratamiento, tratándolos como un proceso continuo con el tiempo en lugar de puntos aislados.
El objeto de la computación está cambiando gradualmente: una persona con el tiempo, junto con sus mediciones, documentos e historial de consultas. Este es un cambio fundamental en cómo se enmarca el problema.
El organismo es un sistema dinámico, mientras que gran parte de la infraestructura médica todavía está diseñada para registrar eventos separados. Un laboratorio obtiene un valor, un médico escribe una conclusión, un paciente sufre una prueba, se prescribe tratamiento. Tres meses después viene otro punto. Sin embargo, el sistema biológico no se detiene entre esos puntos: sigue cambiando.
3. Aquí es donde comenzó BIOS
Al diseñar BIOS, situamos en el centro del sistema la condición de una persona y su cambio con el tiempo. Los documentos, pruebas, diagnósticos y funciones individuales del producto deben servir a esa tarea. Este fue el punto de partida de nuestra arquitectura.
Tenemos muchas observaciones heterogéneas: valores de laboratorio, documentos médicos, historia, recetas, síntomas, datos de estudio y, en el futuro, datos utilizables y otras fuentes. La tarea de BIOS no es simplemente montarlos en una pantalla.
Cada observación, su procedencia, tiempo y contexto deben ser preservados e integrados en una historia personal continua. A continuación, se compara una nueva observación con las anteriores para establecer lo que ha cambiado, pasando gradualmente de eventos separados a la reconstrucción estatal, la comparación estatal y el análisis de trayectoria.
En la práctica, esta compleja arquitectura debe ofrecer un resultado sencillo. El sistema debe ayudar a responder a cuatro preguntas:
- ¿Cuál es la condición actual de la persona?
- ¿Qué ha cambiado significativamente?
- ¿Qué tendencia se puede observar?
- ¿Qué información sigue siendo insuficiente para una evaluación más segura?
Cuanto más compleja sea la tecnología subyacente, más simple será la experiencia del usuario. Los médicos no deben tener que operar un sistema computacional complejo. Deben recibir un contexto más coherente antes y con menos esfuerzo cognitivo.
Lo que queremos decir con el estado de una persona
El objeto de trabajo necesita aclaración. El estado de una persona no puede reducirse a un diagnóstico o a un conjunto de mediciones en un formulario. Sólo vemos observaciones disponibles: pruebas, síntomas, recetas, mediciones y descripciones médicas. De ellos podemos construir una representación más o menos completa de lo que está sucediendo, pero la confianza depende de la calidad y la integridad de la historia.
El tiempo tiene un papel distinto en este modelo. Por el mismo hecho, la fecha del evento, fecha de medición y fecha en que un documento introducido en el sistema puede diferir. Una prescripción puede haber sido cancelada, un resultado revisado o un síntoma registrado retrospectivamente. Si estas distinciones se pierden, un resumen cuidadosamente escrito todavía puede presentar la secuencia del evento equivocada.
Por lo tanto, la memoria médica debe preservar tanto los hechos como la historia de su refinamiento. Un nuevo registro puede extender uno anterior, contradecirlo o cambiar su significado. El sistema debe mostrar lo que apoya la representación actual, que las relaciones se han establecido y donde los datos son insuficientes. Esta es la base necesaria para seguir modelando la dinámica.
Considere un ejemplo hipotético: un nuevo resultado de laboratorio entra en la historia. Compararlo con un resultado anterior requiere unidades, método, tiempo de recogida de muestras y recetas entre las mediciones. Un cambio numérico por sí solo no explica su causa. El trabajo del sistema es preservar esta secuencia y ayudar al médico a probar posibles explicaciones.
Por qué la arquitectura necesita varias capas computacionales
En la presentación del BIOS, el modelo de lenguaje ocupa la capa de interfaz: ayuda a formular preguntas y presentar respuestas. Sus capacidades también son útiles para el procesamiento de textos, pero el almacenamiento de historias médicas, la comparación de fechas y unidades, el control de fuentes e investigación en las transiciones estatales necesitan sus propios mecanismos verificables.
Un enfoque híbrido separa estas tareas para que cada uno pueda ser probado independientemente. Un modelo que escribe un buen resumen puede todavía reconstruir la cronología incorrectamente. Una predicción exacta en un grupo no establece la transferibilidad a otra clínica. El desarrollo ulterior requiere saber qué componente produjo un resultado y dónde surgió un error.
Esta separación también se refiere a la gobernanza de los datos. Los diferentes participantes necesitan diferentes derechos de acceso; los resultados deben conservar la procedencia y los cambios deben ser rastreables. Desarrollar un núcleo tecnológico compartido no significa que los datos médicos puedan fluir libremente entre cada producto y organización.
4. Elegimos deliberadamente un camino más arriesgado
Cuando comenzamos BIOS, habría sido mucho más fácil seguir una ruta de producto familiar: construir un intérprete de pruebas de laboratorio, centrarse en una categoría de datos o crear un asistente médico. Elige una función que sea fácil de explicar al mercado y mejorarla constantemente.
Nos aconsejaron repetidamente hacer exactamente eso: estrechar el alcance, simplificar y posponer la arquitectura compleja. Ganar los ingresos de un producto directo primero, y construir la tecnología fundamental más adelante.
Nos arriesgamos deliberadamente: mantener el destino fijo mientras permanece libre de cambiar la ruta. Podemos cambiar escenarios de usuario, el orden de lanzamientos de productos, el modelo comercial e integraciones. Pero si nuestro objetivo final es la condición de una persona con el tiempo, cada producto liberado hoy también debe convertirse en parte de ese sistema futuro.
De lo contrario, en algunos años podríamos tener una colección comercialmente exitosa de características que deben ser completamente reconstruidas para crear la tecnología para la que se fundó la empresa.
5. Por qué este riesgo tiene sentido económico
A primera vista, una arquitectura fundamental significa un camino más largo y costoso. En un horizonte más largo, sin embargo, debe tener el efecto opuesto.
Estamos construyendo un sistema de módulos informáticos y de productos relativamente independientes que comparten un enfoque común de los datos y el estado. Por lo tanto, un nuevo producto no necesita significar un nuevo sistema. Puede ser una nueva combinación de componentes existentes.
Hoy en día, una combinación forma un producto para los médicos, otro para los pacientes. Otras combinaciones pueden servir laboratorios, investigaciones o escenarios clínicos especializados.
La arquitectura se convierte en un activo de negocios en su propio derecho. Construimos valor no sólo en la interfaz y conjunto de datos acumulado, sino en cómo estado está representado, los cambios se procesan y los componentes interactúan. Esto es mucho más difícil de copiar que el exterior del producto.
Una base tecnológica: cuatro casos de uso
La presentación describe cuatro direcciones: Personal, Doctor, Clínica e Investigación. Los pacientes necesitan un historial de salud personal y una comprensión de los cambios. Los médicos necesitan contexto clínico, datos estructurados e hipótesis comprobables. Las clínicas necesitan continuidad entre citas y especialistas. La investigación requiere datos longitudinales de alta calidad, resultados definidos y análisis de cohortes reproducibles.
Estos escenarios colocan diferentes demandas en interfaces, acceso y garantía de calidad. La arquitectura compartida evita reconstruir fuente, tiempo y procesamiento de relaciones para cada producto. Lanzamiento de un caso de uso de la investigación todavía requiere el manejo de datos organizados por separado, los motivos apropiados y un protocolo; no sigue automáticamente de tener una solicitud de paciente.
Evaluar la economía de tal sistema requiere medir la reutilización: cuántos componentes sirvieron al siguiente producto, cuánto tiempo tomó una nueva fuente para integrarse, y qué cambió al trasladarse a otra clínica. Estas medidas ayudan a determinar si la arquitectura se convierte realmente en un activo que reduce los costos de desarrollo futuros.
6. De la evaluación estatal a las modalidades de transición
Otra capa tecnológica es fundamental para nosotros: operadores neuronales. Esta ha sido una dirección fuerte en la informática científica en los últimos años. Anima Anandkumar y su equipo en Caltech han desempeñado un papel importante en su desarrollo.
Los operadores neuronales fueron desarrollados inicialmente para modelar sistemas físicos complejos. Su idea central es aprender no sólo una correspondencia entre dos conjuntos fijos de parámetros, sino un operador de transformación: un patrón por el cual una función o mapas estatales a otra. En la informática científica, esto permite trabajar en resoluciones espaciales y, en algunas tareas, acelera sustancialmente la solución de modelos físicos complejos. Esto ya se ha demostrado en la dinámica de fluidos y otros sistemas descritos por ecuaciones diferenciales.
Nuestro objetivo no es transferir un método mecánicamente de la física a la medicina, sino transferir la forma en que se formula el problema. Si la salud es un sistema dinámico, la pregunta no es sólo si su estado actual puede ser clasificado. Queremos saber si podemos formalizar patrones de transición desde el estado A — bajo condiciones e intervenciones específicas— hasta el estado B.
Esta es una tarea de investigación considerablemente más difícil, y la que pretendemos probar sistemáticamente. Si se confirma la hipótesis, podría tener consecuencias prácticas: una nueva tarea podría ya no requerir la formación de un sistema separado de cero en un enorme conjunto de datos especializado cada vez.
Podríamos reutilizar una representación existente de dinámicas y adaptar módulos individuales. Esto debería reducir los datos especializados necesarios y, por tanto, el tiempo y el costo de la capacitación.
La modularidad permite sustituir y reconfigurar piezas individuales sin recrear toda la plataforma. El procesamiento adicional de los cambios estatales debe reducir la computación redundante y mejorar la velocidad de procesamiento. La separación de componentes computacionales permite arreglos más flexibles para el almacenamiento, el acceso y el procesamiento, y evita un único punto crítico en el sistema.
Una distinción clara es necesaria aquí: estas son nuestras hipótesis tecnológicas y las ventajas esperadas de la arquitectura. En la medicina, la elegancia matemática no es suficiente. Necesitamos pruebas experimentales de que la arquitectura requiere menos datos, mejora la precisión, trabaja más rápido y mantiene la calidad en diferentes grupos de pacientes en tareas médicas específicas. Aquí es donde comienza el trabajo científico del BIOS.
7. Lo que esto cambia para la infraestructura de laboratorio
El mismo principio se aplica en todo el sector. Un laboratorio puede combinar diez instrumentos excelentes, varios sistemas de información y decenas de fuentes de datos. Pero el número de tecnologías no crea infraestructura.
La infraestructura emerge cuando la salida de un elemento se convierte en una entrada utilizable para el siguiente. Cuando se pueden comparar los resultados y se conserva la procedencia de los datos; al reemplazar un instrumento no se restablece la historia del paciente, y se puede conectar un nuevo módulo sin reconstruir todo el sistema.
Los datos no deben quedar encerrados dentro del sistema de un proveedor. Una solución tecnológica debe crear un activo acumulativo, no otra isla aislada.
Los enfoques descritos en WHO SMART Guidelines Incluye explícitamente componentes estandarizados, legibles por máquina y reutilizables, interoperabilidad y menor dependencia de un solo proveedor. La lógica es la misma: la resiliencia no reside en una aplicación cerrada, sino en un sistema cuyos componentes y datos pueden interactuar y actualizarse sin desmantelar toda la infraestructura.
8. Qué elegir hoy y qué debe demostrarse
Al seleccionar una solución de laboratorio, es importante evaluar no sólo el producto sino también las consecuencias arquitectónicas de adoptarlo. Varias preguntas necesitan respuestas:
- ¿Puede recuperar sus datos?
- ¿Se conserva su procedencia?
- ¿Los resultados son comparables con el tiempo?
- ¿Se puede cambiar un componente sin una migración completa?
- ¿Hay una interfaz abierta para interactuar con otros sistemas?
- ¿Puede la escala de solución?
- ¿La elección de hoy crea más posibilidades mañana, o crea una nueva dependencia tecnológica?
Comparar soluciones requiere más que su precio de compra. Por ejemplo, BIOS Doctor cuesta un médico RUB 2.490 por mes y no requiere equipo separado.
El verdadero costo de una tecnología es más que su licencia. Incluye integración, capacitación, apoyo, tiempo profesional, el costo de errores, migración de datos y eventual reemplazo. Una solución barata hoy en día puede convertirse en la más cara en tres años si la infraestructura tiene que ser reconstruida.
Finalmente, ¿qué ya funciona y qué todavía requiere evidencia? Las funciones de trabajo deben distinguirse de las tareas de investigación. BIOS ya tiene una capa de aplicación operacional: recopilación y estructuración de datos médicos, memoria médica continua, trabajo con contexto longitudinal y productos para médicos y pacientes.
Un modelo formal de estados, transiciones y trayectorias es la siguiente capa de investigación. Para esta capa, debemos demostrar precisión, robustez, transferibilidad, eficiencia computacional y relevancia clínica. Una hipótesis tecnológica se convierte en una tecnología sólo después de dicha evaluación.
La agenda mundial: tareas que conforman el próximo ciclo
A través de la biotecnología, un modelo dinámico de salud forma parte de un programa más amplio. Los investigadores trabajan a diferentes escalas, desde moléculas y células a organismos e historias personales multianuales. La pregunta central es cómo los resultados en estos niveles se conectarán y estarán disponibles para la próxima tarea de investigación.
1. Un estado humano computable
SensorFM y estudios clínico-trayectarios longitudinales demuestran dos rutas: señales continuas diarias e historias de eventos médicos. La siguiente pregunta es cómo alinear estas corrientes, contabilizar los datos perdidos, distinguir el cambio persistente de la fluctuación aleatoria y las predicciones de prueba contra las observaciones futuras.
Este es el enfoque principal del BIOS. Queremos conectar observaciones a la historia, la historia a una representación del estado, e investigar patrones de cambio. Un ejemplo práctico es la preparación de una cita de seguimiento: los médicos necesitan ver qué pasó después de su decisión anterior, qué información ha llegado y qué falta para una conclusión.
2. Genómica en el contexto de la historia clínica
En septiembre de 2026, Google DeepMind presentó AlphaGenome Atlas — predicciones de los efectos funcionales de nueve mil millones de posibles variantes de un solo núcleo en el genoma humano. Esta es la escala del análisis de la variante computacional, no un recuento de personas examinadas. Los autores declaran explícitamente que la herramienta no ha sido validada para uso clínico.
Este ejemplo plantea la siguiente pregunta: ¿cómo puede conectarse una hipótesis molecular a lo que se observa realmente en una persona con el tiempo? Una variante por sí sola no describe todo un historial de salud. La investigación requiere manifestaciones clínicas, condiciones, edad, intervenciones y resultados posteriores. En el futuro, la arquitectura del BIOS debe apoyar esos datos preservando al mismo tiempo los niveles de procedencia y confianza. Las predicciones genómicas todavía necesitan su propia validación.
3. Modelos celulares y conexiones a través de escalas
El documento por Bunne y colegas en la celda virtual considera la combinación de datos celulares heterogéneos en modelos para estudiar procesos biológicos y respuestas a las perturbaciones. Este encuadre lleva conexiones entre los niveles de organización biológica al primer plano.
Song, Segal y Xing establecieron un programa de investigación de alcance relacionado en su documento Cómo construir un organismo digital impulsado por AI: modelos conectados de moléculas, células y organismos deben apoyar la predicción y guiar experimentos. Este es un programa de desarrollo, no un organismo digital universal ya terminado.
BIOS trabaja en otro nivel: historia y estado de una persona. Sin embargo, tenemos que diseñar para conectar observaciones clínicas con hallazgos de tales investigaciones. Una hipótesis sobre un mecanismo celular, por ejemplo, podría compararse con cambios en las mediciones observadas. Esto requiere descripciones de datos compatibles y validación separada de los enlaces a través de escalas.
4. Diseño molecular y de drogas computacional
AlphaFold 3 demuestra la predicción conjunta de las estructuras de complejos que contienen proteínas, ácidos nucleicos, moléculas pequeñas y otros componentes. Estos métodos ayudan a investigar las interacciones moleculares y elegir las direcciones experimentales. Una estructura predicha no establece la eficacia o seguridad de un futuro fármaco.
A medida que avanza el diseño computacional, la retroalimentación de los estudios y la práctica se vuelve más importante: ¿qué efecto se observa, en qué grupos y en qué condiciones? Para BIOS, esta es una posible aplicación de investigación del contexto longitudinal. No reemplazamos las plataformas de diseño molecular; nuestro interés es la calidad de la historia utilizada para estudiar la respuesta de una persona a una intervención.
5. Tecnologías de células y genes: vigilancia a largo plazo
El resultado de una intervención puede necesitar una evaluación más allá del curso de tratamiento inicial. Por ejemplo, Orientación de la FDA sobre el seguimiento a largo plazo después de la terapia génica direcciones retrasadas eventos adversos y la necesidad de observación a largo plazo según los riesgos específicos de un producto.
Por lo tanto, la infraestructura debe preservar la conexión entre el estado de referencia, la intervención y los acontecimientos posteriores. Cambiar clínicas o formatos de documentos no debe romper el historial de investigación. El valor de la memoria médica es especialmente claro aquí. Utilizar BIOS en estos estudios requerirá un protocolo específico, controles de calidad y colaboración con centros de investigación.
6. La interoperabilidad como condición para el progreso en todo el sistema
WHO SMART Guidelines ofrecer un enfoque para traducir las directrices en componentes digitales estandarizados y reutilizables. Abordan una tarea fundamental: hacer que el conocimiento médico sea adecuado para un uso coherente en diferentes sistemas.
Para un laboratorio, el resultado concreto está transmitiendo un valor junto con sus unidades, método y tiempo. Para una clínica, es preservar el significado durante el intercambio. Para un investigador, está rastreando la procedencia de una característica. BIOS trata estos requisitos arquitectónicos desde el principio; de lo contrario, los modelos posteriores dependerán de relaciones cuya validez no pueda ser comprobada.
Qué cambia esto para la ciencia y la práctica médica
Se espera que el programa mundial se centre cada vez más en la conexión de esos niveles. El valor científico surgirá donde el camino puede ser trazado de la observación a la hipótesis, de la hipótesis a la experimentación, y volver a la observación con nuevos conocimientos. Cada relación debe tener condiciones claras de aplicabilidad.
Dentro de este arreglo, BIOS podría conectar historias médicas diarias con tareas de investigación. Para ello, debemos reproducir el contexto: mostrar qué datos se utilizaron, cómo cambió y por qué el sistema llegó a una conclusión particular. Las historias acumuladas podrían entonces apoyar nuevos estudios, mientras que los resultados de la investigación vuelven a la práctica mediante herramientas verificables.
Lo que necesita pasar ahora
Esta perspectiva conduce a decisiones prácticas. No hay necesidad de esperar un modelo de salud universal: gran parte del trabajo necesario puede y debe comenzar con las tareas de hoy.
- Desarrolladores: responsabilidades separadas de componentes. Almacenamiento de datos, extracción de texto, comparación de observación y predicción cada uno necesita sus propias pruebas. El resultado práctico es poder reemplazar un modelo y verificar que la historia y los hechos materiales permanecen intactos.
- Clínicas: elegir un escenario específico y medir el flujo de trabajo de base. Por ejemplo, preparación para una consulta de seguimiento. Antes de la implementación, tiempo récord, integridad de la historia reconstruida y omisiones críticas; después, compare las mismas medidas, incluyendo los casos en que el instrumento no ayudó.
- Laboratorios: preservar el significado de un resultado durante la transferencia. Una medición debe viajar con el método necesario, unidad, tiempo y información de referencia. La prueba es si las historias pueden compararse correctamente después de que una nueva fuente esté conectada.
- Grupos de investigación: evaluación de diseño a través del tiempo. Los pacientes separados entre capacitación y evaluación, excluyen la información futura, definen los resultados por adelantado y la transferibilidad de pruebas. De lo contrario, un modelo puede reconstruir bien la información conocida mientras es inútil para la próxima decisión.
- Inversionistas e instituciones de desarrollo: evaluar la acumulación de un activo tecnológico. Junto con los ingresos del producto, examinar la reproducibilidad, costo de integración, reutilización de componentes y calidad de evidencia. Esto permite financiar el trabajo fundamental mediante hitos comprensibles.
Para BIOS, esto significa abordar tareas prácticas, acumular memoria médica verificable, evaluar la calidad de cada capa y avanzar gradualmente hacia modelos más complejos de dinámica. El trabajo comercial da a la investigación verdaderas limitaciones y criterios de utilidad; la investigación abre posibilidades para la próxima generación de productos.
Conclusión. Cinco principios para el desarrollo del sector
Cinco conclusiones prácticas siguen este enfoque.
- Dejar de medir la soberanía tecnológica por el número de sustitutos nacionales. Necesitamos examinar qué nuevas clases de tecnología podemos crearnos.
- Diseño de continuidad tecnológica, no productos aislados. Los datos, estándares e interfaces deben permitir que los componentes individuales cambien sin desmantelar todo el sistema.
- No separe el desarrollo y la comercialización fundamentales en dos mundos. Los investigadores deben entender las limitaciones del mundo real, y los empresarios deben trabajar no sólo con la demanda actual, sino también con hipótesis tecnológicas.
- Evaluar la innovación en todos los niveles. No presente una hipótesis arquitectónica como resultado clínico comprobado, pero no abandone el desarrollo difícil simplemente porque el mercado todavía no puede articularlo.
- Construir infraestructura para que cada nuevo paso aumente el valor y las posibilidades del trabajo anterior.
Este es el principio que elegimos para BIOS. Tomamos deliberadamente un camino más complejo porque no queremos otro servicio médico que debe ser reemplazado en unos pocos años. Queremos un sistema en el que los datos acumulan significado, módulos individuales se pueden recombinar en nuevos productos, la tecnología se vuelve más precisa a medida que se desarrolla, y la complejidad interna creciente da a los usuarios una herramienta más simple y más clara.
La propuesta central del periódico: la infraestructura construida hoy debe dejarnos abordar problemas que el mercado todavía no ha articulado. Esta capacidad podría convertirse en una base para el liderazgo tecnológico.
Si aprendemos a conectar la ciencia fundamental, la arquitectura de ingeniería y el negocio de esta manera, las conferencias futuras ya no tendrán que discutir sólo cómo reemplazar otra tecnología extranjera. Seremos capaces de discutir las tecnologías creadas aquí que otros están ahora tratando de reproducir.
Fuentes
- Sinsky C. et al. Allocation of Physician Time in Ambulatory Practice. Ann Intern Med. 2016;165:753-760. DOI: 10.7326/M16-0961. Estudio observacional de la asignación de tiempo de los médicos en los Estados Unidos.
- Narayanswamy G. et al. Hacia una inteligencia general y una interfaz para los datos de salud utilizables. arXiv:2605.22759v3, 16 julio 2026. Preprint. Resumen de los autores sobre Google Research, 9 julio 2026.
- Kim E., Foty R., Thakor A. S. et al. Viajes de pacientes longitudinales de datos EHR estructurados y no estructurados. Nature Medicine, 10.09.2026. DOI: 10.1038/s41591-026-04695-x.
- Li Z. et al. Fourier Neural Operator for Parametric Partial Differential Equations. ICLR 2021; arXiv:2010.08895v3. Aprendizaje operativo para problemas descritos por ecuaciones diferenciales.
- Directrices OMS SMART. Componentes de salud digital estandarizados y reutilizables.
- Vasey B. et al. DECIDE-AI. Nature Medicine 28, 924–933 (2022). DOI: 10.1038/s41591-022-01772-9.
- Collins G. S. et al. TRIPOD+AI. BMJ 2024;385:e078378. DOI: 10.1136/bmj-2023-078378. Gallifant J. et al. TRIPOD-LLM. Nature Medicine 31, 60–69 (2025).
- Wu et al. PULSE: modelar estados pasados y actuales. Nature Computational Science, 2026. DOI: 10.1038/s43588-026-01026-5.
- Asgari et al. Estudio de alucinaciones y omisiones en el procesamiento de datos médicos de LLM. npj Medicina Digital, 2025. DOI: 10.1038/s41746-025-01670-7.
- InfEHR: gráficos temporales de historia médica y aprendizaje de representación. Nature Communications, 2025. DOI: 10.1038/s41467-025-63366-6.
- Materiales originales de BIOS.
Las fuentes son actuales al 26 de septiembre de 2026. El programa de evaluación describe la siguiente etapa de investigación de BIOS. Las decisiones de diagnóstico y tratamiento permanecen con los médicos.